L'inférence à partir d'un maillage de GPU indépendants

Une seule API compatible OpenAI pour le chat, le code, les embeddings, les images et la vidéo. Les GPU inactifs, où qu'ils soient, peuvent rejoindre le réseau et gagner des crédits.

Un clic et vous voilà dedans, avec 500 crédits d’essai réclamés pour vous. Sans inscription ni e-mail. Le contenu de l’essai est traité comme public.

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
La passerelle choisit le modèle et un nœud adapté.
12
modèles disponibles
chat, video
ce qu'il peut faire maintenant

API de modèles partagés : utilisez les modèles d'autres personnes ou partagez votre propre crédit

Partagez le crédit d'API que vous n'utilisez pas et gagnez-en, ou utilisez les modèles que d'autres partagent. Pas encore ouvert.

Quatre types de tâches, une clé

L'image et la vidéo ci-dessous ont été générées sur le réseau lui-même.

Chat et code

Demandez auto : la requête est lue, pas conservée. Les questions courtes vont à un modèle rapide, le code à un modèle de code, les problèmes difficiles au plus puissant.

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
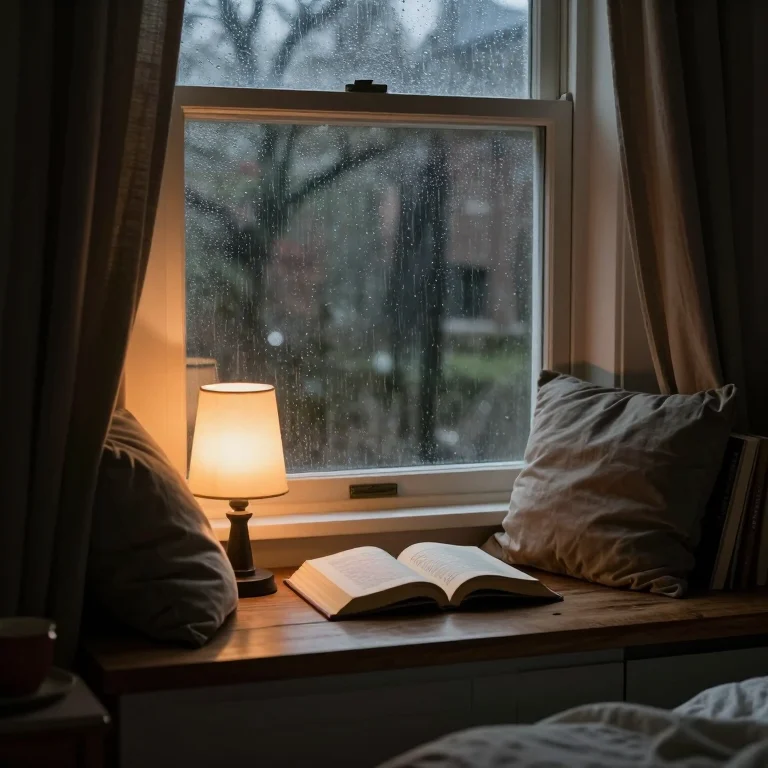
Images

Une phrase, une image.

Une image générée sur le réseau : une lampe de bureau et un livre ouvert près d'une fenêtre par une nuit pluvieuse

Embeddings

Du texte vers des vecteurs pour la recherche et la récupération, avec un petit modèle qui tourne sur des CPU ordinaires.

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

Vidéo

De courts clips, générés en arrière-plan. Cela prend quelques minutes, et le fichier est prêt à enregistrer une fois terminé.

En test : de la parole au texte

Transforme la voix en texte, en anglais ou en chinois. Ce n'est pas encore ouvert à l'utilisation. Ce que vous voyez ci-dessous a été produit sur nos propres machines : appuyez sur lecture et les mots apparaissent au fur et à mesure.

Ce qui arrive à une requête

  1. Envoyer

    Votre application appelle l'API avec une clé, comme n'importe quel service compatible OpenAI.

  2. Répartir

    La passerelle choisit un nœud adapté : le modèle, la longueur de l'invite, la charge actuelle.

  3. Calcul

    Le nœud exécute le modèle et renvoie la réponse en flux par la passerelle.

  4. Vérifier

    Les deux parties signent un reçu, et une partie des résultats est recalculée pour les vérifier.

Prêtez ce que vous avez

Gagnez des crédits pendant que votre ordinateur est inactif. Cela ne démarre qu'après votre accord et vous pouvez arrêter à tout moment.

  • Une carte graphique

    NVIDIA, AMD, Intel ou Apple silicon. Il traite le chat, le code, les images et la vidéo pendant votre absence.

  • Juste un processeur

    Pas de GPU utilisable ? Prêtez le CPU pour de petits modèles et des embeddings. Seule environ la moitié des threads est utilisée.

Aujourd'hui et la suite

Disponible maintenant

  • Chat, code, embeddings, images et vidéo
  • Une API compatible OpenAI : vos outils existants fonctionnent tels quels
  • Une page d'état avec la disponibilité et la vitesse en direct
  • Le client Babel Mesh pour Windows, macOS et Linux, avec partage de GPU et de CPU
  • Une boutique d'agents : des agents prêts à l'emploi pour le travail quotidien avec les fichiers

En cours, sans dates

  • Versement en espèces des crédits gagnés, avec vérification d'identité et examen
  • Plus de modèles, et de plus grands

Questions

Comment est-ce payé ?

L'utilisation est facturée en crédits : au jeton pour le texte et les embeddings, à l'image, et à la seconde de vidéo. On peut aussi gagner des crédits en partageant du calcul.

D'autres peuvent-ils voir ce que j'envoie ?

Le nœud qui traite votre requête peut la lire, mais ne voit pas qui vous êtes. Babel Mesh ne conserve pas les conversations, et les reçus comptables ne contiennent que des empreintes et l'utilisation. Seule une requête qui déclenche une règle de contenu laisse un court extrait autour de l'occurrence. N'envoyez ni mots de passe, ni numéros d'identité, ni autre contenu sensible. Plus de détails sur la page sécurité.

En quoi est-ce différent de la location d'un GPU dans le cloud ?

Les requêtes sont réparties sur de nombreuses machines indépendantes. Vous ne louez pas une machine entière ni ne préparez d'environnement, et vous payez à l'usage. Ce qui est proposé, c'est de l'inférence de modèles, pas de la location de GPU brut.

Quels systèmes et quelles cartes peuvent partager du calcul ?

Windows et Linux (x86-64) avec des cartes NVIDIA (CUDA) ou AMD et Intel (Vulkan), et les Mac à puce Apple silicon (Metal). Un ordinateur sans carte graphique utilisable peut partager son processeur.